한 줄로
- 아스트라 발표에서 인프라 관점의 핵심 숫자는 벤치마크 점수가 아니라 작업 하나에 약 40분입니다.
- 작업이 길어지면 그 작업의 문맥이 40분 내내 어딘가에 살아 있어야 합니다. 그 자리가 HBM입니다.
- 그래서 에이전트가 늘어날 때 먼저 조여지는 것은 연산 성능이 아니라 메모리 용량과 대역폭입니다.
아스트라가 바꾼 것은 점수가 아니라 작업의 길이
오픈AI가 공개한 GPT-6 아스트라의 벤치마크는 확실히 눈에 띕니다. 회사가 직접 공개한 수치입니다.
GPT-5.6 솔 대비 (오픈AI 발표 기준)
- Terminal-Bench Science 0.1: 22.4%에서 64.6%로. 터미널과 코드로 과학 연구 절차를 수행하는 능력
- AutomationBench: 18.1%에서 41.4%로
- ARC-AGI-3: 7.8%에서 99.9%로
이 숫자들은 모델 이야기입니다. 인프라 관점에서 더 중요한 것은 같은 발표에 함께 있던 다른 두 줄입니다.
인프라 쪽에서 봐야 할 두 줄
- OSWorld 2.0에서 72.6%를 기록했는데, 작업 하나에 약 40분이 걸렸습니다. 이전 모델보다 47% 빨라진 결과가 그렇습니다
- 긴 문맥 시험(MRCR v2, 바늘 8개)에서 25만6천에서 51만2천 토큰 구간 100%, 51만2천에서 100만 토큰 구간 96.3%
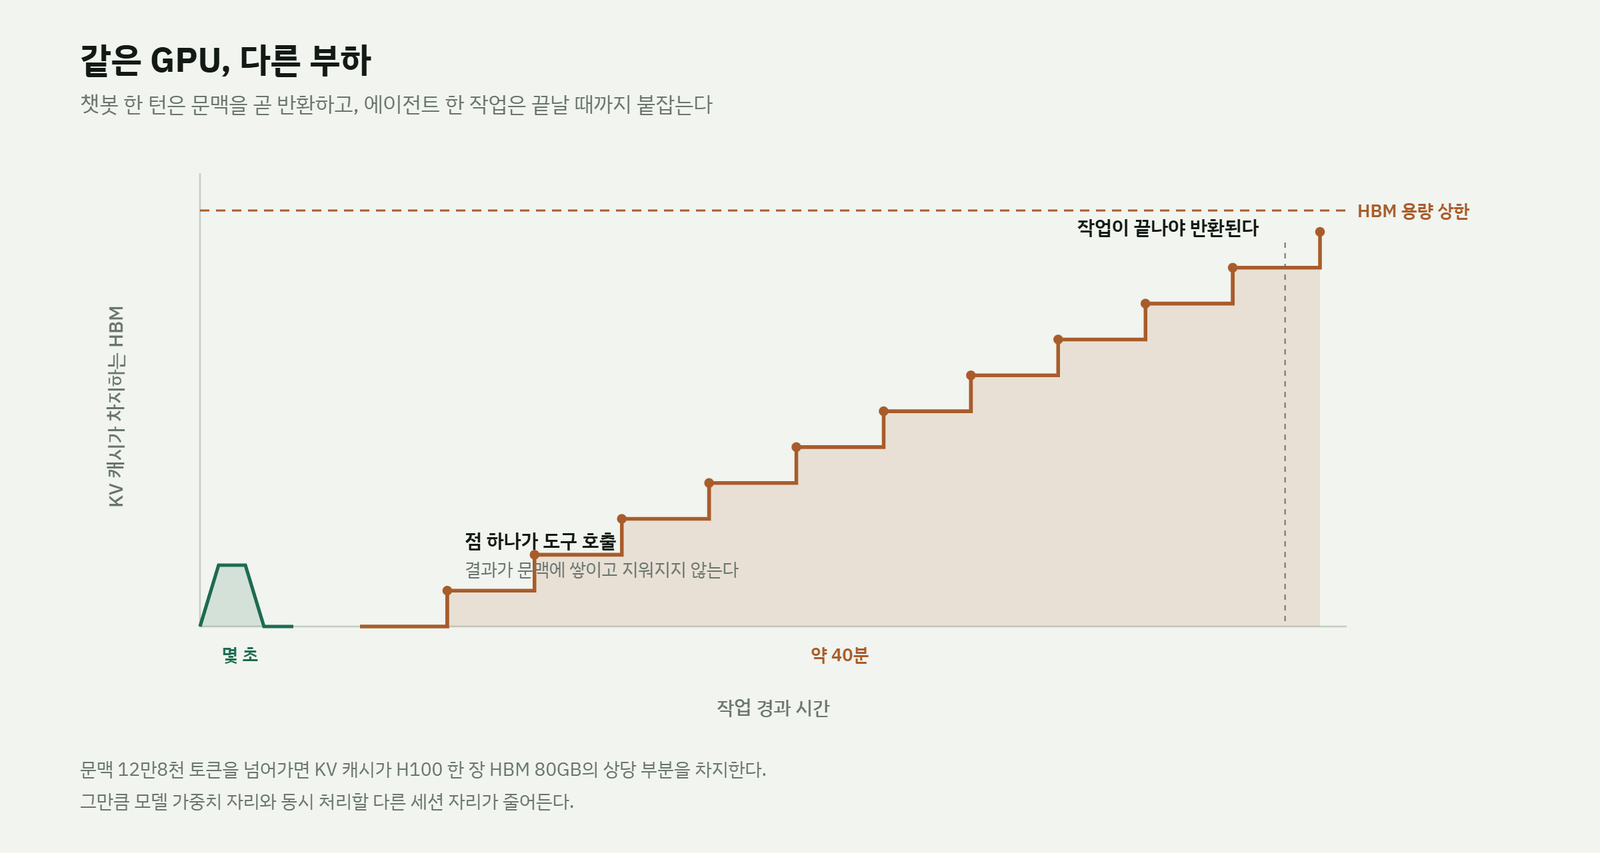
이 두 줄을 붙이면 그림이 나옵니다. 백만 토큰짜리 문맥을 실제로 쓸 수 있는 모델이, 작업 하나를 40분 동안 붙잡고 있습니다. 챗봇 한 턴은 몇 초 만에 끝나고 문맥도 짧습니다. 40분과 몇 초는 같은 종류의 부하가 아닙니다.
ARC-AGI-3의 99.9%는 벤치마크가 사실상 포화됐다는 뜻이기도 합니다. 점수가 높다는 것과 그 능력이 실제 업무로 옮겨간다는 것은 다른 이야기이고, 벤치마크 점수는 모델을 만든 회사가 자사 기준으로 발표한 값입니다. 이 글에서는 점수를 성능 증명이 아니라 워크로드 성격이 바뀌었다는 신호로만 씁니다.
왜 긴 작업이 메모리 문제가 되나
언어 모델은 토큰을 하나씩 만듭니다. 다음 토큰을 만들려면 앞에 나온 모든 토큰을 다시 참고해야 합니다. 매번 처음부터 다시 계산하면 너무 느리므로, 앞 토큰들을 계산해둔 중간 결과를 메모리에 쌓아두고 재사용합니다. 이것이 KV 캐시입니다.
KV 캐시의 성질이 이 글의 전부입니다. 문맥이 길어질수록 선형으로 커지고, 작업이 끝날 때까지 버릴 수 없습니다. 그리고 이 캐시는 GPU에 붙은 HBM 안에 있어야 합니다. 다른 데 있으면 매 토큰마다 가지러 가야 해서 의미가 없습니다.
숫자로 보면 이렇습니다. 문맥이 12만8천 토큰을 넘어가면 KV 캐시가 H100 한 장의 HBM 80기가바이트 가운데 상당 부분을 차지합니다. 모델 가중치가 들어갈 자리와 동시에 처리할 다른 사용자 자리가 그만큼 줄어듭니다.
챗봇에서는 이 압박이 가끔 옵니다. 에이전트에서는 상시입니다. 작업이 진행될수록 지금까지의 판단, 도구 호출 결과, 읽은 문서가 전부 문맥에 쌓이기 때문입니다. 40분짜리 작업은 40분 동안 계속 자라는 캐시를 붙잡고 있는 작업입니다.
계산이 아니라 대역폭이 막는다
추론은 두 단계로 나뉩니다.
프리필과 디코드
- 프리필: 입력 문맥을 한 번에 처리해 캐시를 만드는 단계. 행렬 연산이 크게 몰려서 연산 성능이 중요합니다
- 디코드: 토큰을 하나씩 뱉는 단계. 토큰 하나마다 캐시 전체를 다시 읽어야 합니다. 읽어야 할 양은 많은데 계산량은 적습니다
디코드가 메모리 대역폭에 걸린다는 뜻입니다. 연산 유닛은 데이터를 기다립니다. 이 상태에서는 GPU의 연산 성능을 두 배로 올려도 출력 속도가 두 배가 되지 않습니다. 대역폭이 두 배가 되어야 두 배가 됩니다.
에이전트는 디코드 비중이 큰 워크로드입니다. 사람이 읽을 답 몇 줄을 뽑는 게 아니라, 도구를 호출하고 결과를 읽고 다시 판단하는 과정을 수십 번 반복하면서 출력 토큰을 계속 만들어냅니다. 그래서 에이전트가 늘어난다는 것은 대역폭이 병목인 구간의 비중이 늘어난다는 뜻입니다.
그래서 어느 층이 조여지나
이 블로그가 계속 쓰는 방식대로 층으로 나눠보면 이렇습니다.
에이전트가 늘 때 조여지는 순서
- HBM 용량: 같은 패키지 안에 더 많이 담아야 합니다. 그래서 층을 더 쌓으려는 압력이 생깁니다
- HBM 대역폭: 디코드가 여기 걸립니다. HBM4가 핀 속도가 아니라 폭을 두 배로 늘린 이유이기도 합니다
- 캐시를 밀어낼 자리: HBM에 다 못 담으면 밖으로 내보내야 합니다. 12만8천 토큰 문맥에서 캐시를 외부 저장으로 옮긴 시험에서 첫 토큰까지 걸리는 시간이 19배 개선됐다는 결과가 보고됐습니다
- 랙 안쪽 배선: 여러 가속기가 하나의 긴 작업을 나눠 맡으면 그 사이로 문맥이 오갑니다
첫 번째와 두 번째는 HBM 16단이 왜 어려운가와 HBM3E와 HBM4는 무엇이 다른가에서 각각 다뤘습니다. 네 번째는 랙 안쪽 표준 경쟁입니다. 오늘 새로 붙는 것은 세 번째, 즉 HBM 바깥에 캐시를 두는 계층이 별도의 시장으로 생겨나고 있다는 점입니다.
시장의 해석과 구조의 차이
이번 발표 직후 시장은 이것을 메모리 이야기로 읽었습니다. 그 읽기의 방향은 맞습니다. 다만 이유가 흔히 말하는 것과 조금 다릅니다.
흔한 설명은 “모델이 좋아지면 계산이 더 필요하다”입니다. 더 정확한 설명은 “작업이 길어지면 기억이 더 필요하다”입니다. 이 차이가 중요한 이유는, 앞의 문장에서는 연산과 메모리 수요가 같은 비율로 늘지만 뒤의 문장에서는 그렇지 않기 때문입니다.
반대쪽도 적어둡니다. 이 그림이 그대로 굴러가려면 에이전트가 실제로 기업 업무에 들어가야 합니다. 벤치마크 점수와 도입률은 다른 숫자이고, 지금까지 둘 사이의 간격은 좁지 않았습니다. 그리고 캐시를 아끼는 기법(문맥 압축, 캐시 재사용, 선택적 저장)이 빠르게 개선되면 필요한 메모리가 예상보다 덜 늘 수도 있습니다. 이 글은 방향을 말하는 것이지 기울기를 말하는 것이 아닙니다.
같이 읽을 글
- AI 학습과 추론은 무엇이 다른가: 추론은 그 안에서 또 한 번 갈린다
- KV 캐시란 무엇인가: 가중치는 고정이고 대화는 자란다
- 메모리 대역폭이란 무엇인가: 용량은 담는 양, 대역폭은 꺼내는 속도
- 출하는 16.7% 줄고 매출은 6.3% 늘었다: 메모리가 가격표를 다시 썼다
- HBM 16단은 왜 어려운가: 높이가 775마이크로미터로 묶여 있다
- HBM3E와 HBM4는 무엇이 다른가: 빨라진 게 아니라 넓어졌다
- HBM이란? AI 반도체에서 메모리가 병목이 된 이유
- NVLink와 UALink: AI 랙 안쪽의 표준 전쟁
벤치마크 수치는 오픈AI가 공개한 발표 자료 기준이고, KV 캐시와 HBM 점유에 관한 수치는 공개된 업계 자료를 근거로 했습니다. 틀린 것이 확인되면 날짜를 적어 고칩니다.
뉴스레터
AI 인프라 뉴스를 구조로 읽는 법
새 글이 올라오면 메일로 보내드립니다. 그날 뉴스에서 어느 고리가 움직였는지만 짧게 정리합니다.
광고 메일은 보내지 않습니다. 해지는 메일 하단에서 한 번에 됩니다.