한 줄 요약
- KV 캐시는 이미 계산해 둔 문맥을 메모리에 남겨 두는 장치입니다. 계산을 메모리로 바꾸는 거래입니다.
- 가중치는 사용자가 늘어도 그대로지만, KV 캐시는 사용자 수와 대화 길이에 정비례해서 자랍니다.
- 그래서 KV 캐시는 HBM의 용량과 대역폭을 동시에 조이는 유일한 항목입니다.
API 가격표를 보면 줄이 하나 더 있습니다. GPT-5.6 Sol은 입력 100만 토큰에 5.00달러인데, 그 아래 캐시된 입력이 0.50달러로 따로 적혀 있습니다. GPT-5.6 Terra는 2.00달러와 0.20달러, 제미나이 3.8 플래시는 0.75달러와 0.075달러입니다. 세 줄 모두 정확히 10분의 1입니다.
더 눈에 띄는 항목은 구글 쪽에 있습니다. 캐시를 붙잡아 두는 값을 따로 받습니다. 100만 토큰당 시간당 0.50달러입니다. 토큰을 처리한 값이 아니라, 메모리를 점유한 시간에 매기는 값입니다.
이 세 숫자가 왜 이렇게 생겼는지 알려면 KV 캐시가 무엇인지부터 봐야 합니다.
KV 캐시란 무엇인가
언어 모델은 토큰을 하나 만들 때마다 앞의 모든 토큰을 다시 봅니다. 이때 각 토큰을 두 가지 형태로 바꿔 놓고 참조합니다. 어느 토큰이 지금 필요한지 찾는 데 쓰는 값이 키(Key)이고, 찾은 뒤 실제로 가져오는 내용이 값(Value)입니다. 두 글자를 따서 KV입니다.
문제는 이 K와 V가 매번 같다는 점입니다. 100번째 토큰을 만들 때 계산하는 1번 토큰의 K와 V는, 99번째 토큰을 만들 때 계산한 것과 완전히 동일합니다. 그런데도 다시 계산하면 n번째 토큰마다 n개를 계산해야 하니 전체 비용이 길이의 제곱으로 늘어납니다.
그래서 한 번 계산한 K와 V를 버리지 않고 메모리에 남겨 둡니다. 이것이 KV 캐시입니다. 다음 토큰을 만들 때는 새로 들어온 토큰 하나만 계산해서 뒤에 붙이면 됩니다.
핵심
KV 캐시는 성능 최적화가 아니라 교환입니다. 다시 계산하는 비용을 없애는 대가로, 대화가 끝날 때까지 메모리를 붙잡아 둡니다. 연산이 줄어든 만큼 메모리가 늘어납니다.
KV 캐시는 얼마나 큰가
크기는 정확히 계산됩니다. 토큰 하나가 차지하는 바이트 수는 다음과 같습니다.
메타가 공개한 라마 3 70B의 구성을 넣어 보겠습니다. 레이어 80개, 어텐션 헤드 64개, KV 헤드 8개, 모델 차원 8,192입니다. 헤드 차원은 8,192 나누기 64로 128이고, 16비트 자료형이라 2바이트입니다.
327,680 × 131,072(12만 8천 토큰) = 약 42.9GB (2진 단위로는 정확히 40GiB)
H100 SXM 한 장의 메모리가 80GB입니다. 컨텍스트를 끝까지 채운 대화 하나가 GPU 한 장의 53.7%를 씁니다. 사용자 두 명이면 한 장으로는 안 됩니다.
여기서 짚어 둘 것이 있습니다. 위 계산에서 KV 헤드가 8개인데 어텐션 헤드는 64개입니다. 여러 개의 질의 헤드가 하나의 KV를 공유하는 구조이고, 이를 GQA라고 부릅니다. 만약 헤드마다 KV를 따로 두는 옛 방식이었다면 토큰당 2.5MB, 12만 8천 토큰이면 320GiB입니다. GQA가 이미 8배를 깎아 놓은 뒤의 숫자가 42.9GB라는 뜻입니다.
왜 긴 대화가 비싼가
추론 서비스의 원가 구조는 두 항목으로 갈립니다.
메모리를 쓰는 두 항목
- 가중치: 70B 파라미터에 2바이트씩, 140GB입니다. 사용자가 1명이든 1,000명이든 변하지 않습니다.
- KV 캐시: 사용자 수 × 각자의 대화 길이에 정비례합니다.
H100 8장으로 묶은 서버 한 대의 메모리는 640GB입니다. 가중치 140GB를 먼저 올려놓으면 남는 것이 500GB입니다. 컨텍스트를 채운 대화 하나가 42.9GB니까 나눠 보면 이렇게 됩니다.
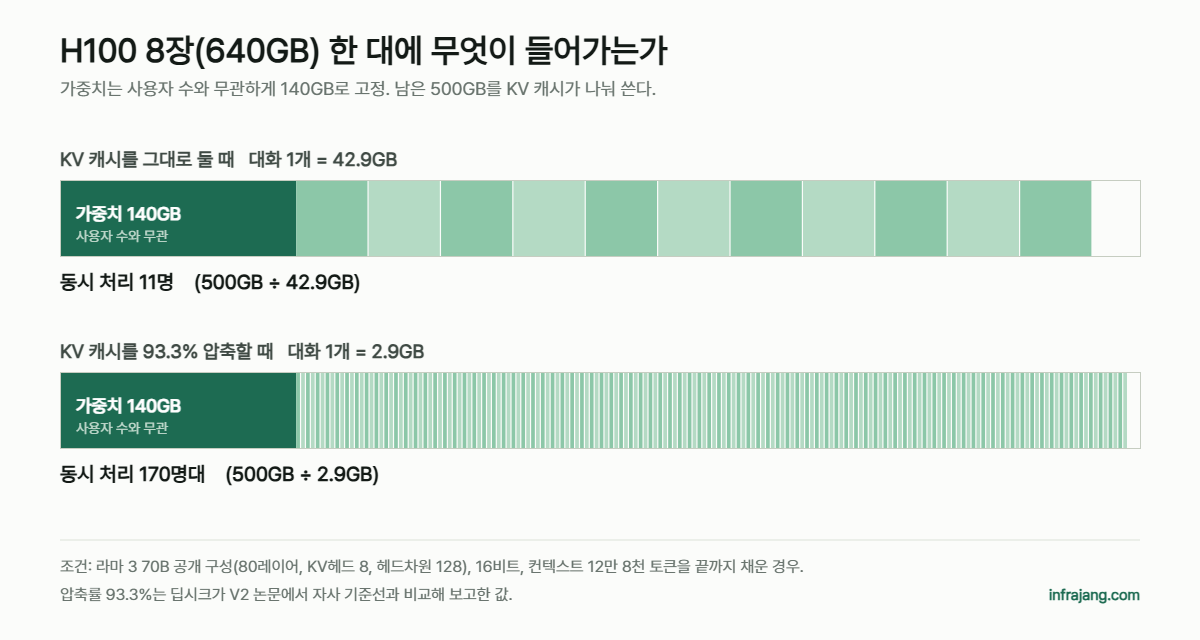
GPU 8장이 동시에 11명입니다. 같은 서버가 짧은 질의만 받으면 수백 명을 처리합니다. 가중치는 그대로인데 KV 캐시만 달라져서 생긴 차이입니다. 컨텍스트 길이가 곧 동시 처리 인원의 상한이 되고, 그 상한이 토큰 단가로 넘어옵니다.
이것이 가격표에서 긴 컨텍스트가 별도로 취급되는 이유이고, 구글이 캐시 점유를 시간당으로 청구하는 이유입니다. 메모리 사용료를 임대료처럼 받는 것입니다.
캐시된 입력은 왜 10분의 1인가
추론은 성격이 다른 두 구간으로 나뉩니다.
프리필과 디코드
- 프리필: 입력으로 받은 문장 전체의 K와 V를 한꺼번에 계산합니다. 병렬로 돌릴 수 있어서 연산 장치를 꽉 채워 씁니다. 연산 집약적 구간입니다.
- 디코드: 토큰을 하나씩 만듭니다. 토큰 하나를 만들 때마다 가중치 140GB 전체와 KV 캐시 전체를 다시 읽습니다. 계산량은 적고 읽는 양은 많습니다. 대역폭 집약적 구간입니다.
캐시 적중은 프리필을 건너뛰는 것입니다. 같은 앞부분을 다시 보냈을 때, 그 부분의 K와 V가 아직 메모리에 남아 있으면 계산 없이 그대로 씁니다. 사라지는 것은 연산이고, 그래서 값을 깎아 줍니다.
그러면 조건이 왜 붙는지도 설명됩니다. 오픈AI 문서 기준으로 GPT-5.6 이후 모델은 최소 1,024 토큰부터 캐시가 걸리고, 캐시된 앞부분은 마지막으로 쓰인 뒤 30분 동안만 재사용 대상입니다.
- 최소 길이가 있는 이유: 토큰 하나 단위로 캐시를 관리하면 관리 비용이 이득보다 커집니다. 그래서 덩어리 단위로 다룹니다.
- 만료가 있는 이유: 캐시가 남아 있는 동안 HBM을 계속 점유합니다. 위에서 본 11명이라는 상한이 그만큼 줄어듭니다. 무한정 붙잡아 둘 수 없어서 시간을 끊습니다.
줄이는 방법은 세 가지뿐이다
KV 캐시가 메모리를 조인다는 사실이 확인된 뒤, 업계가 택한 길은 셋으로 정리됩니다.
첫째: 낭비를 없앤다
KV 캐시는 대화가 얼마나 길어질지 미리 알 수 없습니다. 그래서 기존 시스템은 최대 길이만큼 연속된 공간을 미리 잡아 두었습니다. 실제로 쓰이는 것은 그 일부입니다. vLLM 논문이 측정한 값은 이렇습니다. 기존 시스템에서 KV 캐시 영역의 20.4%에서 38.2%만 실제 토큰을 담고 있었습니다. 나머지 60%에서 80%는 예약분과 조각입니다. 운영체제가 메모리를 페이지로 쪼개 관리하는 방식을 그대로 가져와서 이 낭비를 없앤 것이 PagedAttention이고, 논문이 보고한 처리량 개선은 2배에서 4배입니다.
둘째: 캐시 자체를 줄인다
위에서 본 GQA가 첫 단계였습니다. 그다음은 K와 V를 더 작은 형태로 압축해서 저장하고, 쓸 때 복원하는 방식입니다. 딥시크가 V2에서 쓴 MLA가 이 계열입니다. 논문이 보고한 값은 KV 캐시 93.3% 감소, 최대 생성 처리량 5.76배, 학습 비용 42.5% 절감입니다. 위의 42.9GB에 93.3%를 적용하면 2.9GB가 되고, 같은 서버의 동시 처리 인원은 11명에서 170명대로 올라갑니다.
셋째: 메모리를 늘린다
앞의 두 방법은 소프트웨어입니다. 셋째는 하드웨어이고, 이 블로그가 계속 따라온 이야기로 되돌아옵니다.
그래서 병목은 어디에 걸리나
메모리를 쓰는 두 항목을 다시 보면, 성격이 다릅니다.
KV 캐시 : 토큰마다 커지고(용량), 토큰마다 다시 읽힌다(대역폭).
KV 캐시는 AI 추론에서 용량과 대역폭을 동시에 먹는 유일한 항목입니다. 커져서 자리를 차지하는데, 자리를 차지한 뒤에도 토큰 하나마다 전부 다시 읽힙니다. 용량이 부족하면 동시 처리 인원이 줄고, 대역폭이 부족하면 한 사람의 응답 속도가 줄어듭니다. 어느 한쪽만 올려서는 해결되지 않습니다.
이것이 HBM이 두 축을 동시에 밀어붙이는 이유입니다. 단수를 12단에서 16단으로 올리는 일은 용량 쪽이고, HBM4가 인터페이스를 1,024비트에서 2,048비트로 넓힌 일은 대역폭 쪽입니다. 서로 다른 두 개의 개발 과제로 보이지만, 압력의 출처는 하나입니다.
지난 2년의 이야기가 계산 장치에서 메모리로 옮겨온 이유를 한 문장으로 줄이면 이렇게 됩니다. 모델을 키우는 일은 가중치를 늘리는 일이라 용량 문제이지만, 모델을 오래 쓰게 만드는 일은 KV 캐시를 늘리는 일이라 용량과 대역폭 문제가 됩니다. 에이전트처럼 한 작업이 몇십 분 이어지는 사용 방식이 늘어난다는 것은, 뒤쪽 문제가 커진다는 뜻입니다.
자주 묻는 질문
KV 캐시와 CPU 캐시는 같은 것인가요
이름만 같습니다. CPU의 L1, L2, L3 캐시는 하드웨어이고, 자주 쓰는 데이터를 느린 메모리 대신 빠른 소용량 메모리에 임시로 두는 장치입니다. KV 캐시는 하드웨어가 아니라 데이터입니다. 모델이 계산해 낸 K와 V 값을 GPU 메모리(HBM)에 담아 둔 것이고, 크기는 대화 길이에 따라 자랍니다. 공통점은 다시 만드는 비용을 아끼려고 결과를 보관한다는 발상뿐입니다.
KV 캐시는 GPU 메모리에만 있나요
기본은 HBM입니다. HBM이 가장 빠르기 때문입니다. 다만 HBM에서 밀려난 캐시를 CPU 메모리나 SSD로 내려 두었다가 필요할 때 다시 올리는 방식도 쓰입니다. 이 경우 계산은 아끼지만 옮겨 오는 시간이 듭니다. 어느 쪽이 이득인지는 다시 계산하는 비용과 옮겨 오는 비용의 비교로 결정됩니다.
컨텍스트 윈도우가 크면 항상 좋은가요
쓸 수 있는 한도가 커지는 것과, 그 한도를 채워 쓰는 것은 다른 이야기입니다. 위 계산대로 12만 8천 토큰을 실제로 채우면 대화 하나가 42.9GB를 점유합니다. 그래서 컨텍스트를 길게 쓰는 요청은 대체로 단가가 다르게 매겨지거나 처리 순서가 뒤로 밀립니다. 한도는 상한이지 무료 구간이 아닙니다.
캐시된 입력을 쓰면 답이 달라지나요
계산을 건너뛰는 것이지 다른 값을 쓰는 것이 아니므로, 같은 입력에 대한 K와 V는 동일합니다. 다만 캐시는 앞부분이 완전히 같을 때만 걸립니다. 문장 맨 앞에 매번 달라지는 내용(시각, 사용자 이름 같은 것)이 들어가면 그 뒤가 아무리 같아도 적중하지 않습니다. 고정된 부분을 앞으로, 달라지는 부분을 뒤로 두는 것이 캐시를 살리는 순서입니다.
확인 필요
- 계산은 이론값입니다. 토큰당 320KB와 12만 8천 토큰 42.9GB는 공식에 라마 3 70B의 공개 구성을 넣은 값입니다. 실제 서비스는 여기에 활성값 버퍼, 조각, 페이지 정렬 손실이 더 붙어서 더 큽니다.
- 16비트를 가정했습니다. 가중치 140GB와 KV 캐시 계산 모두 파라미터와 캐시를 2바이트로 잡았습니다. 8비트나 4비트로 낮춰 쓰는 경우가 많고, 그러면 이 숫자들은 절반이나 4분의 1이 됩니다.
- 11명이라는 상한은 최대 컨텍스트를 채운 경우입니다. 실제 요청 대부분은 컨텍스트를 다 쓰지 않으므로 동시 처리 인원은 훨씬 많습니다. 이 숫자는 최악의 경우를 보여주기 위한 것입니다.
- 1,024 토큰 최소치와 30분 만료의 해석은 제 것입니다. 조건 자체는 오픈AI 문서에 적힌 값이지만, 그 이유를 관리 단위와 HBM 점유로 설명한 부분은 공개된 근거가 아니라 구조에서 끌어낸 추론입니다.
- MLA의 93.3%는 딥시크가 자사 모델을 자사 기준선과 비교한 값입니다. 다른 모델에 그대로 적용되는 비율이 아니고, 압축과 복원에 드는 연산이 늘어나는 대가가 함께 붙습니다.
- 가격은 조회 시점 기준입니다. 위에 적은 단가와 캐시 할인율은 2026년 9월 10일 각 사 문서에서 확인한 값이며, 인하 경쟁이 진행 중이라 바뀔 수 있습니다.
같이 읽을 글
- AI 학습과 추론은 무엇이 다른가: 추론은 그 안에서 또 한 번 갈린다
- 메모리 대역폭이란 무엇인가: 용량은 담는 양, 대역폭은 꺼내는 속도
- 에이전트는 계산보다 기억을 더 쓴다: 아스트라가 인프라에 던진 숙제
- HBM3E와 HBM4는 무엇이 다른가: 빨라진 게 아니라 넓어졌다
- HBM 16단은 왜 어려운가: 높이가 775마이크로미터로 묶여 있다
참고한 1차 자료: 오픈AI API 가격 및 프롬프트 캐싱 문서, 구글 제미나이 API 가격 및 컨텍스트 캐싱 문서, 메타 The Llama 3 Herd of Models(arXiv 2407.21783) 표 3, 엔비디아 H100 제품 사양, Efficient Memory Management for Large Language Model Serving with PagedAttention(arXiv 2309.06180), DeepSeek-V2(arXiv 2405.04434).
글: Watt
뉴스레터
AI 인프라 뉴스를 구조로 읽는 법
새 글이 올라오면 메일로 보내드립니다. 그날 뉴스에서 어느 고리가 움직였는지만 짧게 정리합니다.
광고 메일은 보내지 않습니다. 해지는 메일 하단에서 한 번에 됩니다.