TL;DR
- AI 인프라의 연결 표준 싸움은 두 층에서 따로 벌어진다. 랙 안쪽(스케일업)과 랙 사이(스케일아웃)다.
- 랙 안쪽에서 엔비디아 NVLink는 지금 압도적이다. GPU 매출의 약 95%를 쥐고 있다.
- 그런데 확장성은 개방 표준이 앞선다. UALink 1.0은 스위치 한 단으로 1,024개, NVSwitch는 두 단 거쳐 576개다.
- 엔비디아의 대응은 잠그기가 아니라 열어주기다. NVLink Fusion으로 남의 칩을 자기 패브릭에 끌어들인다.
먼저 층을 나눠야 한다
AI 데이터센터의 연결망은 두 종류입니다. 이 구분을 놓치면 뉴스가 뒤섞여서 읽힙니다.
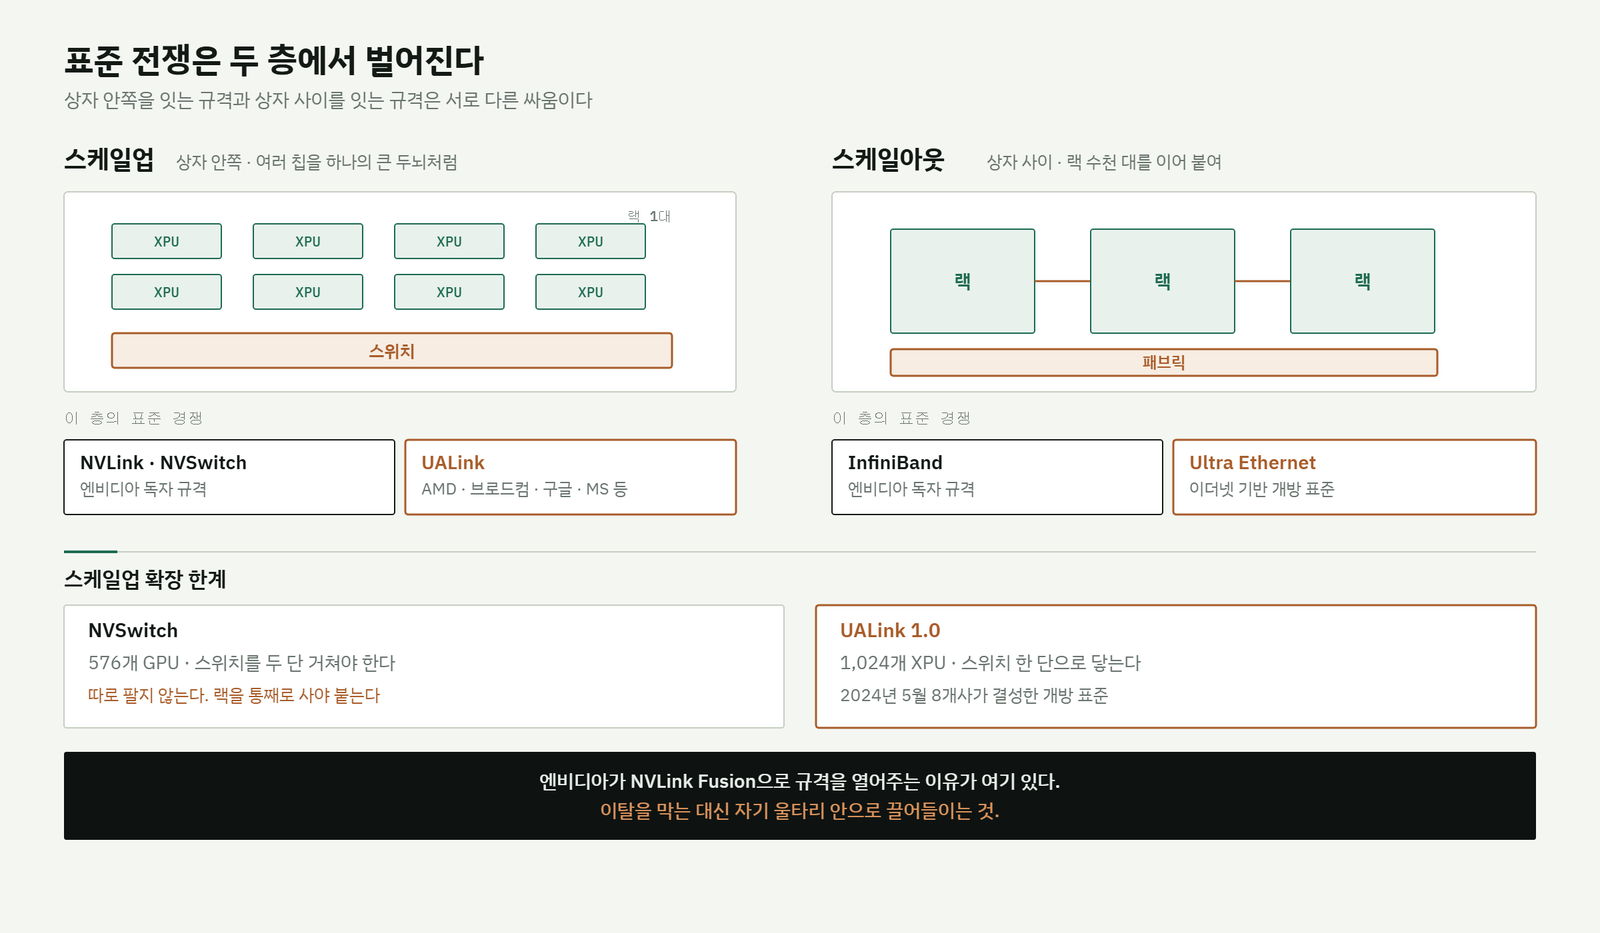
스케일업은 한 상자, 즉 랙 안쪽입니다. 연산 칩 수십 개를 초고속으로 묶어 사실상 하나의 큰 두뇌처럼 쓰게 만드는 연결입니다. 메모리를 공유해야 하니 지연이 극단적으로 낮아야 합니다.
스케일아웃은 그 상자들 사이입니다. 랙 수천 대를 이어 붙여 규모를 키우는 연결입니다. 여기서는 지연보다 규모와 비용이 중요합니다.
두 층에 각각 다른 표준 경쟁이 걸려 있습니다. 스케일업은 엔비디아의 NVLink와 NVSwitch 대 개방 표준 UALink, 스케일아웃은 엔비디아의 InfiniBand 대 이더넷 기반 Ultra Ethernet입니다.
랙 안쪽에서 무엇이 걸려 있나
스케일업 표준을 쥐면 랙 전체를 팔 수 있습니다. 엔비디아는 NVSwitch를 따로 팔지 않습니다. Grace나 Vera 계열 CPU, Blackwell이나 Rubin 계열 GPU와 함께 NVSwitch가 들어간 랙을 통째로 사야 합니다. 부품 하나를 표준으로 쥐면 시스템 전체의 구매 방식을 정할 수 있다는 뜻입니다.
지금 위치는 압도적입니다. 엔비디아는 GPU 매출의 약 95%, 자체 칩을 포함한 GPU와 XPU 합산으로는 약 75%를 쥐고 있습니다.
| 항목 | NVLink · NVSwitch | UALink |
|---|---|---|
| 묶는 범위 | 랙 안쪽 (스케일업) | 랙 안쪽 (스케일업) |
| 한 단으로 닿는 규모 | 576개 GPU · 스위치 두 단 필요 | 1,024개 XPU · 한 단 |
| 소유 | 엔비디아 독자 규격 | 8개사가 만든 개방 표준 |
| 구매 방식 | 따로 팔지 않는다. 랙을 통째로 | 여러 업체 하드웨어를 섞는다 |
| 출발 | 현재 사실상의 표준 | 2024년 5월 결성, 2025년 4월 1.0 |
표에서 눈에 걸리는 줄은 두 번째입니다. 확장성에서는 개방 표준이 앞섭니다. UALink 1.0은 스위치 한 단으로 1,024개 가속기를 묶는데, NVSwitch는 두 단을 거쳐야 576개에 닿습니다. 단을 하나 더 거치면 지연이 늘고 장비도 더 듭니다.
UALink는 2024년 5월에 AMD, 브로드컴, 시스코, 구글, HPE, 인텔, 메타, 마이크로소프트가 결성했습니다. 이 명단이 중요합니다. 엔비디아의 가장 큰 고객들이 대항 표준을 만드는 쪽에 있습니다.
엔비디아의 대응은 잠그기가 아니다
보통 이런 상황에서 예상되는 대응은 더 단단히 잠그는 것입니다. 엔비디아는 반대로 갔습니다.
NVLink Fusion은 엔비디아가 자기 연결 규격을 남의 칩에도 열어준 프로그램입니다. 다른 회사가 설계한 커스텀 칩도 NVLink 포트를 달면 엔비디아의 패브릭에 낄 수 있습니다. 최근 몇 주에 걸쳐 이 문이 얼마나 넓게 열렸는지가 드러났습니다.
- 미디어텍: 엔비디아가 8월 31일 미디어텍이 발행한 전환사채 35억 달러어치를 사들였습니다. 그 대가로 미디어텍은 NVLink Fusion에 접근해, 고객이 원하는 성능과 메모리 용량, 전력 목표에 맞춘 커스텀 가속기를 만들고 그것을 엔비디아 랙 시스템에 꽂을 수 있게 됩니다.
- AWS: 같은 시기에 엔비디아 GPU 추가 배치와 NVLink Fusion 통합을 발표했습니다.
- RISC-V: 9월 1일 핫칩스 2026에서 CUDA를 RISC-V 호스트 CPU로 가져가고 NVLink Fusion을 커스텀 RISC-V CPU에도 열겠다고 밝혔습니다. RISC-V를 x86과 Arm에 이은 서버 CPU 제3의 선택지로 규정했고, RISC-V 쪽 NVLink Fusion CPU 파트너로 SiFive를 지목했습니다. 조건으로는 RVA23 프로필 준수와 88 PCIe 레인급 C2C 인터커넥트를 들었습니다.
이 세 건이 같은 동작입니다. 고객이 자체 칩으로 이탈하려 하면, 그 자체 칩이 자기 패브릭에 꽂히게 만든다. 커스텀 실리콘 시장의 일부를 내주더라도 데이터센터의 뼈대는 계속 쥐고 있겠다는 우회로입니다.
대가는 명확합니다. 열어준 만큼 가속기 판매의 독점은 약해집니다. 그런데 앞선 글에서 정리한 대로 지금 AI 인프라의 값은 칩 한 개가 아니라 시스템 단위에서 정해집니다. 그 단위를 쥐는 쪽이 결국 값을 정합니다.
그런데 이 방어는 성공을 보장하지 않는다
엔비디아 자신에게 정확한 전례가 있습니다. InfiniBand입니다.
InfiniBand는 저지연 네트워크의 강자였습니다. 지금도 큰 사업입니다. 2026년 7월로 끝나는 최근 12개월 기준 엔비디아는 InfiniBand로 257억 4,000만 달러를, 이더넷과 NVSwitch를 합쳐 256억 7,000만 달러를 벌었습니다. 두 축이 거의 같은 크기입니다.
그런데 방향은 갈렸습니다. 대형 클러스터에서 InfiniBand는 사실상 정점을 지났고 하이퍼스케일러들은 이더넷 기반 표준으로 옮겨가고 있다는 평가가 나옵니다. 독자 규격이 기술적으로 앞서 있어도 개방 표준이 규모로 따라잡으면 자리를 내주게 된다는 것이 이 산업에서 반복된 패턴입니다.
표준을 잃는 것과 사업을 잃는 것은 다른 얘기입니다.
그래서 무엇을 보면 되나
- UALink 실물이 나오는지: 규격과 제품은 다릅니다. 스위치 칩과 그것을 쓴 시스템이 실제로 출하되는 시점이 분기점입니다.
- NVLink Fusion 채택 명단: 미디어텍, AWS, SiFive 다음에 누가 붙는지. 붙을수록 엔비디아의 우회로가 작동한다는 뜻입니다.
- UALink 결성사가 양쪽에 다 있는지: 같은 회사가 UALink에도 참여하고 NVLink Fusion도 쓰는 경우가 나올 수 있습니다. 그건 표준을 고르는 대신 양다리를 걸어 협상력을 만드는 전략입니다.
- 스케일아웃 쪽 전환 속도: InfiniBand에서 Ultra Ethernet으로 넘어가는 속도가 스케일업의 미래를 미리 보여주는 지표일 수 있습니다.
이 글에 나온 말
스케일업과 스케일아웃 · 스케일업은 한 상자 안에서 칩 여러 개를 묶는 것, 스케일아웃은 그 상자를 수천 대 이어 붙이는 것입니다.
NVLink와 NVSwitch · 엔비디아의 칩간 초고속 연결 기술과 그 교환기입니다. 따로 팔지 않고 랙을 통째로 사야 붙습니다.
UALink · 2024년 5월 8개사가 결성한 개방형 스케일업 연결 표준입니다.
NVLink Fusion · 엔비디아가 NVLink 규격을 외부 업체의 커스텀 칩에도 열어준 프로그램입니다.
InfiniBand · 저지연 스케일아웃 네트워크 규격입니다. 엔비디아가 인수해 보유하고 있습니다.
Ultra Ethernet · 흔한 이더넷에 저지연 기능을 더해 AI 클러스터용으로 개량한 개방 표준입니다.
C2C 인터커넥트 · 칩과 칩을 직접 잇는 고대역폭 통로입니다. CPU와 GPU를 한 몸처럼 붙입니다.
자주 묻는 질문
NVLink와 UALink의 차이는 무엇인가요
둘 다 랙 안쪽을 묶는 스케일업 연결입니다. 다른 것은 성격입니다. NVLink와 NVSwitch는 엔비디아 독자 규격이고 UALink는 여러 회사가 모인 개방 표준입니다. 확장성은 개방 표준이 앞섭니다. UALink 1.0은 스위치 한 단으로 1,024개를 묶고, NVSwitch는 두 단을 거쳐 576개입니다.
스케일업과 스케일아웃은 무엇이 다른가요
스케일업은 한 랙 안에서 연산 칩 수십 개를 사실상 하나의 큰 두뇌처럼 묶는 연결입니다. 메모리를 공유해야 하니 지연이 극단적으로 낮아야 합니다. 스케일아웃은 그 랙들 사이를 이어 규모를 키우는 연결이고, 여기서는 지연보다 규모와 비용이 중요합니다. 그래서 표준 경쟁도 둘로 갈립니다. 스케일업은 NVLink 대 UALink, 스케일아웃은 InfiniBand 대 이더넷 기반 Ultra Ethernet입니다.
왜 엔비디아는 NVLink를 개방하나요
잠그는 것이 아니라 열어주는 방식으로 대응하고 있습니다. NVLink Fusion으로 다른 회사의 칩을 자기 패브릭 안으로 끌어들입니다. 스케일업 표준을 쥐면 부품이 아니라 랙 전체를 팔 수 있기 때문입니다. 실제로 엔비디아는 NVSwitch를 따로 팔지 않고, 그것이 들어간 랙을 통째로 사게 합니다.
이 시장에서 엔비디아의 현재 위치는 어떤가요
랙 안쪽에서는 압도적입니다. GPU 매출의 약 95%, 자체 칩을 포함한 GPU와 XPU 합산으로는 약 75%를 쥐고 있습니다. 다만 이 글은 InfiniBand의 선례도 함께 봅니다. 엔비디아는 그 표준 경쟁에서는 밀렸지만 사업은 지켰습니다.
같이 읽을 글
- 에이전트는 계산보다 기억을 더 쓴다: 아스트라가 인프라에 던진 숙제
- 주문은 매출보다 3.5배 빠른데: 공급이 상단을 정한다
- 미국에서 만들지 않으면 관세: 공정의 위치가 원가가 된다
- 엔비디아 구매 약정이 한 분기에 두 배
- 커스텀 HBM이란? 파운드리가 메모리에 끼어드는 이유
- 마벨 실적과 구글 워런트가 보여주는 커스텀 ASIC의 구조
- 용어 사전
출처
- In The Long Run, Nvidia NVSwitch Is The InfiniBand Of Scale Up AI Networks (The Next Platform)
- NVIDIA MediaTek Partnership Deepens With 3.5 Billion Investment (StorageReview)
- NVIDIA RISC-V for NVIDIA GPUs at Hot Chips 2026 (ServeTheHome)
- UALink final specs support up to 1,024 GPUs (Toms Hardware)
안내
이 글은 AI 인프라 산업의 구조를 이해하기 위한 해설입니다. 운영자는 금융투자업 인가를 받은 자가 아니며, 이 사이트는 투자 자문을 제공하지 않습니다. 언급된 기업명은 산업 구조를 설명하기 위한 예시이며 특정 기업에 대한 평가나 권유가 아닙니다. 표준의 채택 방향에 관한 서술은 인용된 분석의 견해이며 확정된 사실이 아닙니다. 자세한 내용은 고지 사항을 참고하세요.
뉴스레터
AI 인프라 뉴스를 구조로 읽는 법
새 글이 올라오면 메일로 보내드립니다. 그날 뉴스에서 어느 고리가 움직였는지만 짧게 정리합니다.
광고 메일은 보내지 않습니다. 해지는 메일 하단에서 한 번에 됩니다.