한 줄로
- 용량은 얼마나 담느냐이고, 대역폭은 1초에 얼마나 꺼내오느냐입니다. 둘은 다른 축입니다.
- 계산은 단순합니다. 버스 폭 곱하기 전송률 나누기 8이 초당 바이트입니다.
- AI에서 이 숫자가 중요한 이유는, 모델이 답을 쓰는 속도가 연산이 아니라 대역폭으로 정해지는 구간이 있기 때문입니다.
메모리 대역폭이란 무엇인가
메모리 대역폭은 메모리가 1초에 옮길 수 있는 데이터의 양입니다. 단위는 보통 GB/s(초당 기가바이트)를 씁니다.
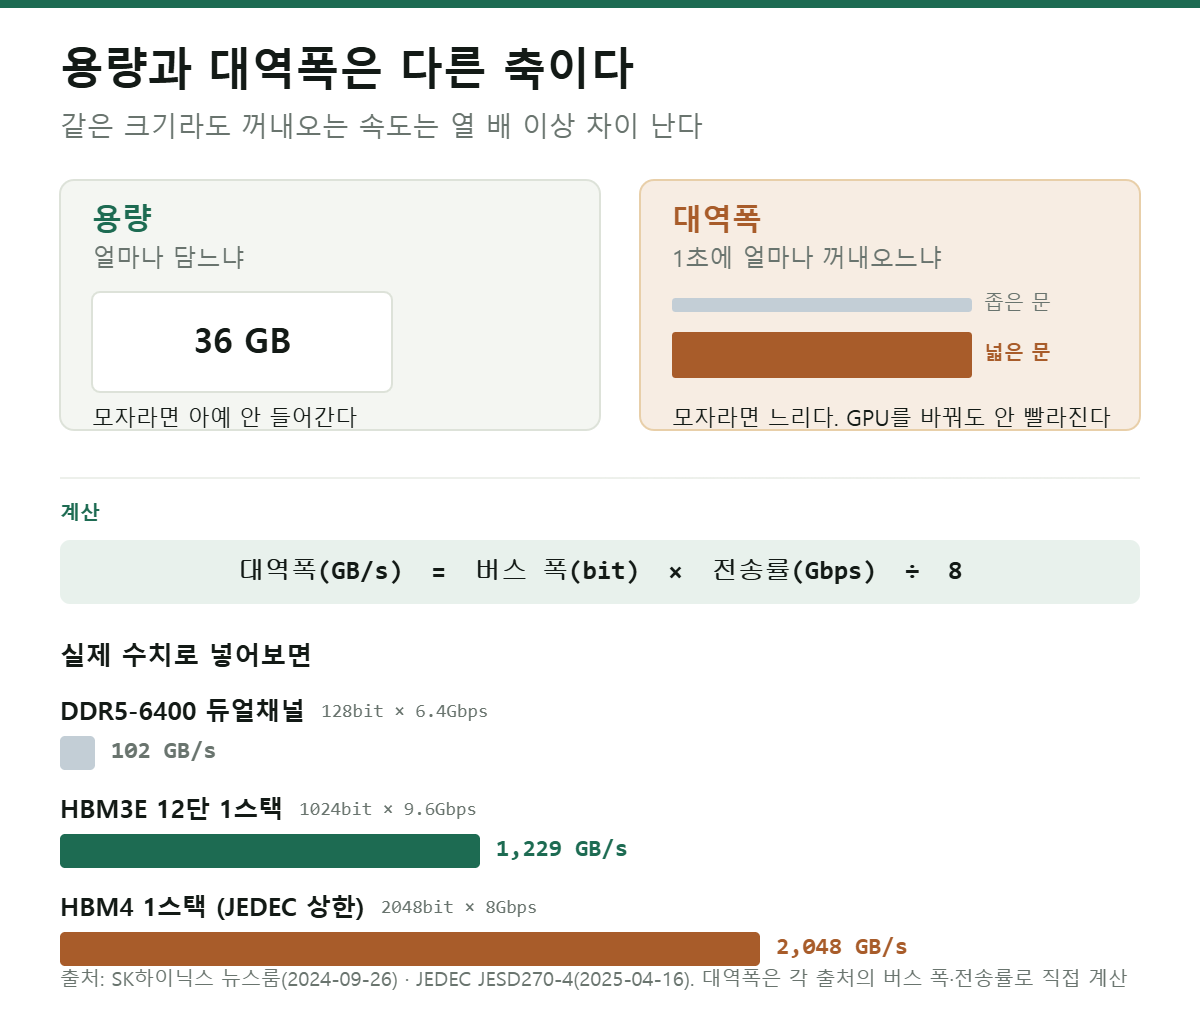
용량과 혼동하기 쉬운데 다른 이야기입니다. 창고에 비유하면 용량은 창고의 크기이고, 대역폭은 창고 문의 너비입니다. 창고가 아무리 커도 문이 좁으면 물건을 빨리 꺼낼 수 없습니다. 반대로 문이 넓어도 창고가 작으면 애초에 담아둘 것이 없습니다.
그래서 두 숫자는 서로를 대체하지 못합니다. 같은 36GB짜리 메모리가 대역폭은 열 배 차이가 날 수 있고, 실제로 그런 제품들이 함께 팔립니다.
메모리 대역폭은 어떻게 계산하나요
필요한 값이 두 개뿐입니다. 데이터가 지나가는 길의 폭과, 그 길에서 1초에 몇 번 데이터를 실어 보내는지를 나타내는 전송률입니다.
8로 나누는 것은 비트를 바이트로 바꾸기 위해서입니다. 1바이트가 8비트니까요.
PC에 흔히 쓰는 DDR5-6400을 넣어보겠습니다. 채널 하나가 64비트이고 전송률이 6.4Gbps입니다.
128 × 6.4 ÷ 8 = 102.4 GB/s (듀얼채널)
데스크톱에 램을 두 개 꽂으면 듀얼채널이 되어 폭이 128비트가 됩니다. 그래서 대역폭도 두 배입니다. 램 하나를 두 개로 쪼개 꽂으라는 조언이 나오는 이유가 이것입니다.
HBM은 얼마나 넓은가
같은 식을 HBM에 적용하면 격차가 보입니다.
SK하이닉스가 2024년 9월 양산을 시작한 12단 HBM3E는 용량 36GB, 전송률 9.6Gbps입니다. HBM3E의 버스 폭은 1024비트입니다.
DDR5 듀얼채널의 약 열두 배입니다. 폭이 128비트에서 1024비트로 여덟 배 넓어졌고, 전송률도 더 높기 때문입니다.
JEDEC이 2025년 4월 확정한 HBM4 표준(JESD270-4)은 여기서 한 번 더 넓힙니다. 버스 폭 2048비트, 전송률 최대 8Gbps로 스택 하나당 최대 2TB/s입니다.
여기서 눈여겨볼 대목이 있습니다. HBM4는 전송률이 HBM3E보다 오히려 낮습니다(9.6에서 8Gbps로). 그런데 대역폭은 늘었습니다. 폭을 두 배로 만들었기 때문입니다. 빨라진 게 아니라 넓어진 것입니다. 이 이야기는 따로 정리한 글에 더 있습니다.
왜 중요한가요
여기가 이 글의 핵심입니다.
AI 모델이 글자를 하나 만들 때, 모델의 가중치를 전부 한 번 읽어야 합니다. 그다음 글자를 만들 때도 또 전부 읽습니다. 계산량은 글자 하나당 얼마 안 되는데, 읽어야 할 양은 매번 모델 크기만큼입니다.
그래서 이 구간에서는 초당 몇 글자를 뱉는지가 이렇게 정해집니다.
SK하이닉스가 발표에서 든 예가 정확히 이 계산입니다. GPU 하나에 12단 HBM3E 네 개를 붙이면 700억 파라미터 모델을 1초에 35번 읽을 수 있다고 했습니다. 숫자를 넣어보면 맞습니다.
700억 파라미터 × 2바이트 = 140 GB
4,915.2 ÷ 140 = 약 35회
이 구간에서는 GPU 연산 성능을 두 배로 올려도 속도가 두 배가 되지 않습니다. 계산 장치가 데이터를 기다리고 있기 때문입니다. 대역폭이 두 배가 되어야 두 배가 됩니다.
대역폭과 용량, 어느 쪽이 먼저 막히나
둘 다 막힙니다. 다만 막히는 이유가 다릅니다.
- 용량이 부족하면 모델이나 작업 문맥이 아예 들어가지 않습니다. 못 돌립니다.
- 대역폭이 부족하면 돌아가기는 하는데 느립니다. 그리고 GPU를 더 좋은 것으로 바꿔도 안 빨라집니다.
작업이 길어질수록 이 둘이 같이 조여집니다. 작업 중에 쌓이는 중간 결과(KV 캐시)가 용량을 먹고, 그것을 매번 다시 읽느라 대역폭도 먹습니다. 이 구조는 에이전트 워크로드를 다룬 글에서 다뤘습니다.
밸류체인에서 이게 뭘 뜻하나
대역폭을 늘리는 방법이 둘뿐이라는 점이 중요합니다. 전송률을 올리거나, 폭을 넓히거나입니다.
전송률을 올리는 것은 신호 품질과 전력 문제에 부딪힙니다. 그래서 HBM4가 선택한 길이 폭을 넓히는 쪽이었습니다. 그런데 폭을 넓히면 연결선이 두 배가 되고, 그것을 물리적으로 붙이는 일이 어려워집니다. 병목이 메모리 안에서 패키징으로 옮겨갑니다.
그래서 대역폭 경쟁은 메모리 회사만의 경쟁이 아닙니다. 폭을 넓힌 스택을 로직 칩에 붙이는 공정, 그 높이를 규격 안에 맞추는 문제, 늘어난 선에서 신호를 유지하는 문제가 같이 붙습니다. 어느 공정이 병목이고 어느 공정이 범용인지를 갈라 보는 것이 여기서 의미를 갖습니다.
확인 필요
위 계산은 이론상 최대치입니다. 실제로는 접근 패턴, 지연, 컨트롤러 효율 때문에 이보다 낮게 나옵니다. 제품 스펙표의 대역폭과 실측 대역폭은 다른 숫자입니다.
700억 파라미터를 140GB로 잡은 것은 파라미터당 2바이트(FP16) 기준입니다. 더 낮은 정밀도로 압축하면 읽어야 할 양이 줄어들고, 그만큼 필요한 대역폭도 줄어듭니다.
HBM4의 2TB/s는 JEDEC 표준의 상한이고, 실제 제품이 그 상한에서 나올지는 제조사별로 다릅니다.
자주 묻는 질문
메모리 대역폭과 용량은 무엇이 다른가요?
용량은 담을 수 있는 양(GB), 대역폭은 1초에 옮길 수 있는 양(GB/s)입니다. 창고 크기와 창고 문 너비의 차이입니다. 같은 용량이라도 대역폭이 열 배 차이 날 수 있습니다.
메모리 대역폭은 어떻게 계산하나요?
버스 폭(bit)에 전송률(Gbps)을 곱하고 8로 나누면 GB/s가 나옵니다. DDR5-6400 듀얼채널이면 128 곱하기 6.4 나누기 8이니 102.4 GB/s입니다.
DDR5의 대역폭은 얼마인가요?
속도 등급에 따라 다릅니다. DDR5-6400 기준으로 채널 하나가 51.2 GB/s, 듀얼채널이 102.4 GB/s입니다. 등급이 올라가면 비례해서 늘어납니다.
램을 두 개 꽂으면 왜 빨라지나요?
버스 폭이 64비트에서 128비트로 두 배가 되기 때문입니다. 용량이 늘어나는 것과는 별개로 대역폭이 두 배가 됩니다.
AI에는 왜 대역폭이 중요한가요?
모델이 글자 하나를 만들 때마다 가중치 전체를 다시 읽습니다. 그래서 초당 생성 속도가 대역폭을 모델 크기로 나눈 값에 묶입니다. 이 구간에서는 GPU 연산을 늘려도 빨라지지 않습니다.
같이 읽을 글
- 2.5D와 3D 패키징은 무엇이 다른가: HBM은 왜 GPU 위에 올라가지 않나
- AI 학습과 추론은 무엇이 다른가: 추론은 그 안에서 또 한 번 갈린다
- AI 데이터센터는 전력을 어디에 쓰나: PUE 하나가 GPU 10만 장을 가른다
- KV 캐시란 무엇인가: 가중치는 고정이고 대화는 자란다
- 멈춘 원전을 2029년에 다시 켠다: 병목이 칩 바깥으로 나갔다
- HBM3E와 HBM4는 무엇이 다른가: 빨라진 게 아니라 넓어졌다
- 에이전트는 계산보다 기억을 더 쓴다: 아스트라가 인프라에 던진 숙제
- HBM 16단은 왜 어려운가: 높이가 775마이크로미터로 묶여 있다
출처 ·
SK하이닉스 뉴스룸 (2024-09-26, 12단 HBM3E 양산) ·
JEDEC JESD270-4 HBM4 표준 (2025-04-16)
대역폭 수치는 각 출처가 밝힌 버스 폭과 전송률로 직접 계산했습니다. 계산식은 본문에 적어두었습니다.
이 글은 AI 인프라 밸류체인의 구조를 설명하기 위한 정보 제공 목적으로 작성했습니다. 특정 종목의 매수나 매도를 권유하지 않습니다. 투자 판단과 그 결과에 대한 책임은 투자자 본인에게 있습니다.
뉴스레터
AI 인프라 뉴스를 구조로 읽는 법
새 글이 올라오면 메일로 보내드립니다. 그날 뉴스에서 어느 고리가 움직였는지만 짧게 정리합니다.
광고 메일은 보내지 않습니다. 해지는 메일 하단에서 한 번에 됩니다.