한 줄로
- HBM 패키지의 높이는 775마이크로미터로 사실상 고정돼 있습니다. 로직 웨이퍼 두께와 같은 값입니다.
- 그래서 12단을 16단으로 만든다는 것은 층을 네 개 더 올리는 일이 아니라, 있던 층과 틈을 모두 얇게 만드는 일입니다.
- 병목은 쌓는 개수가 아니라 50마이크로미터 아래로 얇아진 다이의 휨과, 절반으로 좁아진 틈을 메우는 공정입니다.
HBM 16단이란 무엇인가
HBM은 D램 다이를 위로 쌓아 만듭니다. 12단은 열두 장, 16단은 열여섯 장입니다. 지금 양산되는 HBM4는 12단이고, 16단은 아직 품질 검증 단계에 있습니다.
여기까지만 보면 층을 네 장 더 얹는 문제로 보입니다. 실제로는 그렇지 않습니다. 쌓을 수 있는 총 높이가 정해져 있기 때문입니다.
왜 높이를 늘릴 수 없나
SK하이닉스가 2026년 핫칩스에서 밝힌 HBM4의 패키지 규격은 가로세로 12.8 곱하기 11 밀리미터에 높이 775마이크로미터입니다. 1밀리미터도 안 됩니다.
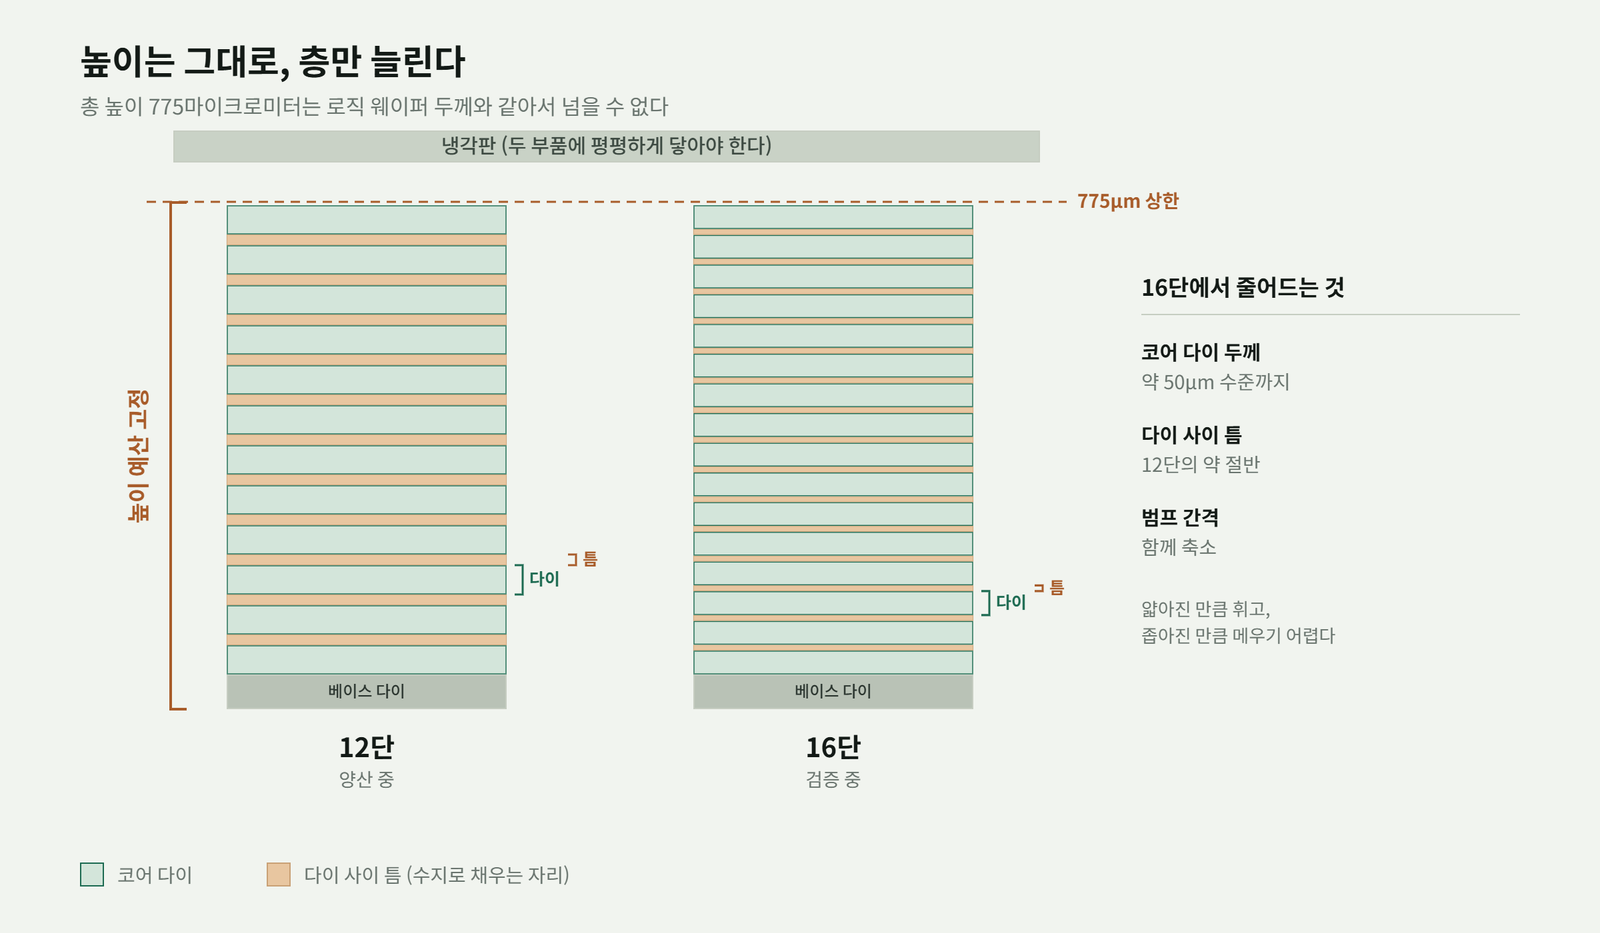
이 775라는 숫자가 어디서 왔는지가 중요합니다. 임의로 정한 값이 아니라 로직 웨이퍼의 두께입니다. HBM은 GPU 같은 로직 칩 옆에 나란히 앉습니다. 그 위에 냉각판을 얹으려면 두 부품의 윗면이 평평하게 맞아야 합니다. 메모리가 로직보다 높으면 냉각판이 메모리에만 닿고 로직에는 뜹니다. 그래서 메모리 높이는 로직 높이를 넘을 수 없습니다.
높이를 정하는 것은 메모리가 아니라 냉각이다
- 패키지 높이 상한 775마이크로미터는 로직 웨이퍼 두께와 같은 값
- 이유는 성능이 아니라 조립: 냉각판이 로직과 메모리에 동시에 닿아야 함
- JEDEC이 이 상한을 올려준 세대마다 기존 공법이 한 세대씩 더 버텨왔음
층을 늘리면 무엇이 얇아지나
총 높이가 고정된 채로 층을 늘리면, 줄일 수 있는 것은 세 가지뿐입니다. 다이 두께, 다이 사이의 틈, 그리고 범프 간격입니다. 실제로 셋 다 줄입니다.
12단에서 16단으로 갈 때 줄어드는 것
- 코어 다이 두께: HBM4 16단에서 약 50마이크로미터 수준까지 얇아집니다. 머리카락 굵기의 절반 정도입니다
- 다이 사이 틈: 12단 대비 약 절반
- 범프 간격: HBM3E에서 16단을 만들 때도 칩 두께, 틈 높이, 범프 간격을 대략 절반씩 줄여야 했습니다
참고로 HBM4 한 스택 안에는 2만 개가 넘는 TSV(다이를 위아래로 관통하는 구멍)와 베이스 다이 쪽 마이크로범프 16,148개가 들어갑니다. 입출력은 2048비트입니다. 이 숫자들이 50마이크로미터짜리 판 위에 얹힙니다.
그래서 진짜 병목은 어디인가
얇게 만드는 것 자체는 됩니다. 문제는 얇아진 다음입니다.
첫째, 휨입니다. 50마이크로미터 아래로 내려간 다이는 종잇장에 가깝습니다. 웨이퍼를 갈아내는 단계에서도 휘고, 쌓아 올리는 단계에서도 휩니다. 휜 다이 위에 다음 다이를 정확히 얹는 것이 16단 공정의 핵심 난제입니다.
둘째, 틈을 메우는 일입니다. 다이 사이의 틈은 수지로 채워야 합니다. 그런데 그 틈이 절반으로 좁아졌습니다. SK하이닉스가 쓰는 MR-MUF는 얇은 다이의 휨에는 강한 대신 틈을 메우는 공정 여유가 좁습니다. 좁아진 틈에 수지를 끝까지 밀어 넣는 것과 다이를 안 휘게 잡는 것을 동시에 해야 합니다.
셋째, 열입니다. SK하이닉스가 제시한 자료에서 세대가 지나며 열 부담은 2.2배로 늘었습니다. 스택 수는 두 세대마다 두 배가 됩니다. 그런데 열이 빠져나갈 통로는 넓어지지 않았습니다. 위에는 냉각판까지 775마이크로미터밖에 없고, 아래에는 열여섯 장의 다이가 있습니다.
이 셋은 서로 맞물립니다. 얇게 만들면 휨이 늘고, 틈을 좁히면 수지가 덜 들어가고, 수지가 덜 들어가면 열이 더 안 빠집니다. HBM 밸류체인 지도에서 병목이 D램 팹 뒤쪽 적층과 검사에 있다고 정리했는데, 16단은 그 병목을 한 번 더 좁히는 일입니다.
하이브리드 본딩은 언제 오나
범프를 없애고 구리를 구리에 직접 붙이는 하이브리드 본딩은 이 문제의 정공법입니다. 범프가 사라진 만큼 같은 높이에 더 두꺼운 코어 다이를 넣을 수 있고, 열 저항도 30퍼센트 넘게 줄어듭니다. 20단 이상과 18마이크로미터 미만 범프 간격은 이 방식이라야 열립니다.
그런데 SK하이닉스는 핫칩스에서 하이브리드 본딩이 HBM4E에도 아직 준비되지 않았다고 말했습니다. 빨라도 HBM5부터라는 뜻이고, 시점으로는 2029년에서 2030년쯤입니다. 엔비디아 베라 루빈용 HBM4 물량은 전부 MR-MUF로 쌓입니다.
이것이 이 글에서 가장 실용적인 부분입니다. 하이브리드 본딩은 기사에 자주 등장하지만, 앞으로 몇 년간 실제로 돈이 오가는 공정은 여전히 MR-MUF입니다. 쌓는 방법의 차이는 쌓는 방법의 갈림길에서 따로 정리했습니다.
16단 코어 다이 두께 약 50마이크로미터는 발표를 전한 매체의 표현이고, SK하이닉스가 수치로 공개한 것은 아닙니다. 수율은 어느 업체도 공개하지 않으므로 이 글에서도 다루지 않았습니다. 판단이 필요하면 수율 추정치보다 실제 출하량을 보시는 편이 낫습니다.
자주 묻는 질문
HBM 16단이란 무엇인가요
D램 다이를 16장 쌓아 만든 HBM입니다. 현재 양산되는 HBM4는 12단이고 16단은 품질 검증 단계에 있습니다. 층을 네 장 더 얹는 문제처럼 보이지만, 쌓을 수 있는 총 높이가 정해져 있어서 실제로는 있던 층과 틈을 모두 얇게 만드는 일입니다.
HBM 패키지 높이는 왜 775마이크로미터인가요
임의로 정한 값이 아니라 로직 웨이퍼의 두께입니다. SK하이닉스가 2026년 핫칩스에서 밝힌 HBM4 패키지 규격은 12.8 곱하기 11 밀리미터에 높이 775마이크로미터입니다. HBM은 GPU 같은 로직 칩 옆에 나란히 앉고, 그 위에 냉각판을 얹으려면 두 부품의 윗면이 평평하게 맞아야 합니다. 메모리가 로직보다 높으면 냉각판이 로직에 닿지 않습니다. 즉 이 높이를 정하는 것은 성능이 아니라 조립과 냉각입니다.
16단이 12단보다 어려운 이유는 무엇인가요
높이가 고정된 채로 층을 늘리면 줄일 수 있는 것은 다이 두께와 다이 사이의 틈뿐입니다. 50마이크로미터 아래로 얇아진 다이는 종이처럼 휘고, 절반으로 좁아진 틈은 메우기가 더 어렵습니다. 병목은 쌓는 개수가 아니라 휨과 틈 충전입니다.
단수를 올리면 대역폭도 같이 오르나요
아닙니다. 단수는 용량을 정하고 대역폭은 인터페이스 폭과 전송률이 정합니다. 그래서 HBM4는 단수와 별개로 인터페이스를 2,048비트로 넓혔습니다. 이 구분은 HBM3E와 HBM4의 차이와 메모리 대역폭 글에서 다뤘습니다.
같이 읽을 글
- 2.5D와 3D 패키징은 무엇이 다른가: HBM은 왜 GPU 위에 올라가지 않나
- TSV란 무엇인가: 구멍 6만 개가 D램을 세로로 세운다
- AI 데이터센터는 전력을 어디에 쓰나: PUE 하나가 GPU 10만 장을 가른다
- KV 캐시란 무엇인가: 가중치는 고정이고 대화는 자란다
- 메모리 대역폭이란 무엇인가: 용량은 담는 양, 대역폭은 꺼내는 속도
- 출하는 16.7% 줄고 매출은 6.3% 늘었다: 메모리가 가격표를 다시 썼다
- 에이전트는 계산보다 기억을 더 쓴다: 아스트라가 인프라에 던진 숙제
- HBM이란? AI 반도체에서 메모리가 병목이 된 이유
- HBM은 왜 SK하이닉스가 앞서 있나: 쌓는 방법의 갈림길
- HBM3E와 HBM4는 무엇이 다른가: 빨라진 게 아니라 넓어졌다
- HBM 밸류체인 지도: 어느 공정이 병목이고 어느 공정이 범용인가
이 글의 수치는 SK하이닉스가 2026년 핫칩스에서 발표한 내용과 이를 전한 공개 보도를 근거로 했습니다. 틀린 것이 확인되면 날짜를 적어 고칩니다.
뉴스레터
AI 인프라 뉴스를 구조로 읽는 법
새 글이 올라오면 메일로 보내드립니다. 그날 뉴스에서 어느 고리가 움직였는지만 짧게 정리합니다.
광고 메일은 보내지 않습니다. 해지는 메일 하단에서 한 번에 됩니다.